一、排序算法#
- 排序算法中经常会用到交换两个数的值的操作,这个操作可以用位运算实现
a = a ^ b;b = a ^ b;a = a ^ b;- 二分法:怎么分?middle 在哪不重要,关键在于对比后赋值,小于middle则直接赋值middle - 1,大于middle则直接赋值middle + 1。
以下是二分查找的代码
int search(int* nums, int numsSize, int target) { int left = 0; int right = numsSize - 1; while (right >= left) { int middle = left + (right - left) / 2; //防止溢出 if (nums[middle] > target) { right = middle - 1; } else if (nums[middle] < target) { left = middle + 1; } else { return middle; } } /* while(left <= right){ int middle = left + (right - left) / 2; if(nums[middle] < target){ left = middle + 1; } else{ right = middle - 1; } } return left; */ //循环到结束一定会得到left = right,而且middle也等于left,此时的target就在left左、右,或者就是left。 return -1;}- 排序算法的稳定性:*如果一个排序算法不改变相同数据之间的相对位置,那么这个排序算法具有稳定性。稳定性对于基本数字类型来说是没有用的,但是对于自己创建的数据类型来说是有用的,在不同维度的排序下不会改变每一条数据的相对位置。*跨越数据进行交换的排序不具有稳定性,相邻的进行交换时具有稳定性,非交换的排序不具有稳定性。
冒泡、插入、归并三种排序具有稳定性,要让归并排序具有稳定性需要优先将左侧的数组放进临时数组中。
- 排序算法的选择:对于归并排序和快排来说,两者都使用了分治和递归的思想,而在递归的过程中需要将大问题拆分成小问题,在数据规模较大时直接使用这两种排序比较快,但是在递归到小问题时往往使用其他的排序能减少实际运行时间。排序算法的优化
1、选择排序#
- **代码思路:**首先选择最左侧的一个数字,将他与剩下的N-1个数字一一对比寻找N个数字中最大(或者最小值),每次对比时将大的(小的)与最左侧的数字交换,然后逐一对比后就能最终找到最值并将其放在最左侧。接下来选择左侧的第二个数字,按照同样的方法与剩下的N-2个数字进行对比,就找到了N-1个数字里的最值。这样对N-1个数字后,所有的数字就全部排列好了。
void SelectSort(int *arr, int size){ for(int i = 0; i < size - 1; i++){ for(int j = i + 1; j < size; j++){ if(arr[i] > arr[j]) { arr[i] = arr[i] ^ arr[j]; arr[j] = arr[i] ^ arr[j]; arr[i] = arr[i] ^ arr[j]; } } }}- 时间复杂度 N的平方
+++
2、冒泡排序#
- **代码思路:**每次都从最左边两个数字开始,每次两个数字进行对比,将比较大的值向右移,一轮过后就将所有数字中的最大值找到并移到最右边了。然后用同样的方法在剩下的N - 1个数字中找到最大的,将它移到右起第二位数字上。
void BubbleSort(int *arr, int size){ for(int i = size; i > 0; i--){ for(int j = 0; j < i; j++){ if(arr[j] > arr[j + 1]) { arr[j] = arr[j] ^ arr[j + 1]; arr[j] = arr[j] ^ arr[j + 1]; arr[j] = arr[j] ^ arr[j + 1]; } } }}3、插入排序#
- **代码思路:**从前往后划分区间,先将1到2区间上排好序,然后将3移进,使得1到3区间有序,重复下去一直到1到N区间上有序。
void InsertSort(int *arr, int size){ for(int i = 1; i < size; i++){ for(int j = i - 1; j >= 0 && arr[j] > arr[j + 1]; j--){ arr[j] = arr[j + 1] ^ arr[j]; arr[j + 1] = arr[j + 1] ^ arr[j]; arr[j] = arr[j + 1] ^ arr[j]; } }}4、归并排序#
- **代码思路:**先分治,利用二分法将所有的数字分成两部分,然后将两部分分别进行排序后,进行两部分的合并,合并过程中再次进行排序,利用递归排序然后不断合并。合并时将两个数组排序到一个临时数组中,从两个数组第一个开始取数,小的数拿到临时数组中,直到一个数组到头,就将另外一个数组全部放入临时数组,最后将临时数组赋给这一段的原数组。
//合并函数void Merge(int *arr, int L, int Mid, int R){ int* index = (int*)malloc(sizeof(int) * (R - L + 1)); int p1 = L; int p2 = Mid + 1; int i = 0; while(p1 <= Mid && p2 <= R){ index[i++] = arr[p1] <= arr[p2] ? arr[p1++] : arr[p2++]; } while(p1 <= Mid){ index[i++] = arr[p1++]; } while(p2 <= R){ index[i++] = arr[p2++]; } for(i = i - 1 ;i >= 0; i--){ index[i] = arr[L + i] }}//递归分治函数void process(int *arr, int L, int R){ if(R == L) return; int Mid = L + (R - L)>>1; process(*arr, L, Mid); process(*arr, Mid, R); merge(arr, L, Mid, R);}- **小和问题:**一个数组里每个数左侧比自己小的数加起来的和等于多少。其实也就是一个数右侧比自己大的数有几个,就要自身加几次。那么使用归并排序,在合并的时候可以计算右侧比自己大的数有几个,并且合并时优先将右侧的数字放进临时数组。
时间复杂度N logN,额外空间复杂度为N,可以通过代码实现空间复杂度为1。
5、快速排序#
-
**荷兰国旗问题:**选定一个数字作为依据划分一个数组,在数组中左边都是小于这个数字的,中间都是等于这个数字的,右边都是大于这个数字的。从头遍历数组,先从头开辟一块 小于块 ,再从后面开辟一块 大于块 ,遍历数组时对每个数字进行对比,如果小于就和 小于块 的下一位数字交换并扩大 小于块 的范围,如果大于就和 大于块 的前一位数字进行交换并扩大 大于块 的范围,如此反复遍历直到便利指针指到 大于块 的前一位。
-
**代码思路:**在一个数组中 随机 选定一个数字,将这个数字和数组末尾交换,然后根据这个数字进行 荷兰国旗划分 ,划分后就得到了前中后三块,中间的数字固定,分别对前后两块进行同样的递归划分。如此递归下去知道每一个最小分块都是一种数字并且和前后的块具有顺序。
void swap(int *arr, int a, int b){ arr[a] = arr[a] ^ arr[b]; arr[b] = arr[a] ^ arr[b]; arr[a] = arr[a] ^ arr[b];}//交换两个数,不允许下标相同void QuickSort(int *arr, int L, int R){ if(L >= R) return; int temp = rand() % (R - L + 1) + L; //生成0到size - 1的随机数 int p1 = L - 1; int p2 = R; int i = L; if (temp != R) swap(arr, temp, R); while(i < p2){ if(arr[i] > arr[R]){ p2--; if(i != p2) swap(arr, i, p2); } else if(arr[i] < arr[R]){ p1++; if(i != p1) swap(arr, i, p1); i++; } else{ i++; } } //注意处理边界问题 swap(arr, p2, R); QuickSort(arr, L, p1); QuickSort(arr, p2 + 1, R);}- 注意:在边界指针和遍历指针移动时,要注意指针重合的问题,指针重合时不要进行两个数字的交换,并且此时已经达到跳出循环的边界。
快速排序选择划分数字时使用的是随机数,也就是说等概率的取到接近中间值的数,等概率的取到最好情况,时间复杂度为 N*log N,使用递归会开辟额外空间,空间复杂度是log N。
6、基数排序#
- **代码思路:**先取出所有数字的个位根据各位放进对应的桶中,然后按照进桶的顺序出桶,然后以十位做相同的操作,以此类推直到完成最大数字的最高位的进桶出桶。
- **进出桶:**使用一个 count数组表示这个桶里面有几个数字,从前向后遍历每一个数的特定位,然后将数字符合的进入桶,也就是 count 数组加一,全部遍历完成后进行前缀和操作,将 count 数组每一位变成前面所有数的和。然后进行出桶时从后向前遍历,每一个数的特定位的对应的 count 数减去1就是这个数在这轮排序后的位置。
void RedixSort(int *arr, int size){ int radix = MaxBits(Max(arr, size)); int count[10] = {0}; int* help = (int*)malloc(sizeof(int) * size); for(int d = 1; d <= radix; d++){ for(int i = 0; i < size; i++){ count[getDigit(arr[i],d)]++; } //入桶 for(int i = 1; i < 10; i++){ count[i] = count[i] + count[i - 1]; } //前缀和 for(int i = size - 1; i >= 0; i--){ help[count[getDigit(arr[i], d)] - 1] = arr[i]; count[getDigit(arr[i], d)]--; } //出桶 for(int i = 0; i < size; i++){ arr[i] = help[i]; } //从辅助数组中拿出来放回原数组进行下一次排序 }}//其中用到的函数有Max()最大值函数//Maxbits()传入一个值找到这个值的有多少位//getDigit()找到一个数的特定位是多少7、堆(Heap)排序#
堆结构就是用数组实现的完全二叉树结构,在完全二叉树中如果每棵子树的最大值都是在顶部就是 大根堆 反之就是 小根堆。
*完全二叉树:*总是先有左子树后有右子树,如果有右子树则必有左子树。
左孩子:left = index * 2 + 1, 父节点:(left - 1) / 2
- **大根堆插入:**将一个数据放到当前的最后一个位置,然后与自己的父节点对比,如果大于自己的父节点,那么和自己的父节点进行交换。
void HeapInsert(int *arr, int index){ while(arr[index] > arr[(index - 1) / 2]){ swap(arr, index, (index - 1) / 2); index = (index - 1) / 2; }}- **堆化:**将一个数据放到任意一个位置,并且将整个堆变成大根堆的形式。 时间复杂度 log N。
void Heapify(int *arr, int index, int Heapsize){ int left = index * 2 + 1; while(left < Heapsize){ int largest = index; if(left + 1 < Heapsize) { largest = arr[largest] < arr[left + 1] ? left + 1 : largest; } largest = arr[largest] < arr[left] ? left : largest; if(largest == index) break; swap(arr, largest, index); left = largest * 2 + 1; index = largest; }}- **代码思路:**使用HeapInsert将数组输入到一个大根堆中,将堆的第一个值(最大值)和最后一个值进行交换,然后Heapsize减小一个,即最大值在最后位置并且脱离堆,然后对刚才交换到根节点的值进行Heapify使得整个堆重新成为大根堆。
void HeapSort(int *arr, int size){ int Heapsize = 0; while(Heapsize < size){ HeapInsert(arr, Heapsize); Heapsize++; } while(Heapsize > 2){ swap(arr, 0, --Heapsize); Heapify(arr, 0, Heapsize); } swap(arr, 0, --Heapsize);}时间复杂度 N log N,空间复杂度1,不占用额外空间。
- **距离为k的数组排序:**确定一个规模为k的堆,这个堆内的排序会很简单,然后将第k + 1个数拿进堆继续排序。
二、数据结构#
1、数组(Array)和链表(LinkList)#
数组空间效率高,支持时间复杂度为1的访问元素,但是缺点也很明显,插入与删除效率很低,而且长度不可变,如果开的数组比较大还会额外浪费空间。
- 数组是存放在连续内存空间上的相同数据类型的集合,内存空间的地址是连续的。二维数组的内存地址也是连续的。
int a[10];memset(a, 0, 10);//初始化数组为0- 数组插入元素时,需要将对应位置后面的所有元素向后移,时间复杂度是O(n)。
void Insert(int *a, int size, int pos, int val) { for(int i = size - 2; i >= pos; i++){ a[i + 1] = a[i]; } a[pos] = val;}- 数组删除元素时,和插入类似,将删除位置之后的所有元素向前移,时间复杂度相同。
void Dlete(int *a, int size, int pos) { for(int i = pos; i < size - 1; i++){ a[i] = a[i + 1]; }}//其实相当于对应位置的元素被覆盖掉链表也是一种顺序表,能够利用离散的内存空间,每个元素节点之间通过指针引用的方式相互连接。
单向链表可用于实现栈、队列、哈希表、图等数据结构。在链表的同一端进行插入和删除时,表现为栈;在链表的两端进行插入和删除操作时,表现为队列。链式结构可用于解决哈希冲突。图中的每一个顶点代表着一个链表,链表中的元素是与这个顶点相连的所有的点。
双向链表用于快速查找前后的元素,结构体中有两个指针,一个指向前一个元素另一个指向后一个元素,可以进行两个方向的遍历,使得寻找元素更加快速,但是占用了更多的空间。。
环形链表用于需要周期性操作的场景,最后一个元素节点指向第一个元素节点,使用环形链表时,要使得链表中至少有一个元素,头指针就指向这个元素。。
链表起始位置有一个头指针HeadNode,HeadNode没有数据,只有一个指向下一个节点的指针。
在头指针后面可以有一个头结点,头结点也是没有数据,为了方便某些操作所以引入头结点。接下来的代码中都是没有头结点的。
typedef int Elemtype; //元素的类型,可以把int改成所需要的数据类型typedef int Status; //状态指示,作为函数的返回值- 创建链表节点的结构体,结构体中有该节点的数据和指向下一个节点的指针,构造函数给数据赋值,使指针为空。
struct ListNode{ Elemtype data; ListNode *next; ListNode(Elemtype x) : data(x), next(nullptr){};}- 要创造一个链表其实就是创建一个头指针来代表一整个链表,使用函数创造一个数据为任意值的节点作为头指针。
ListNode* CreatList(){ ListNode *HeadNode = new ListNode(0); return HeadNode;}- 链表的插入分为头插法、尾插法和指定位置插入。
//头插法Status InsertByHead(ListNode *HeadNode, Elemtype Data){ ListNode *NewNode = new ListNode(Data); NewNode->next = HeadNode->next; HeadNode->next = NewNode; return 1;}//头插法将自己指向下一个节点,然后将头指针指向自己//尾插法Status InsertByTail(ListNode *HeadNode, Elemtype Data){ if(!HeadNode) return -1; //如果头指针指向空意味着链表中没有元素
ListNode *NewNode = new ListNode(Data); ListNode *p = HeadNode; while(p->next != nullptr){ p = p->next; } p->next = NewNode; NewNode->next = nullptr; return 1;}//创建一个遍历指针,从头指针开始遍历,如果下一个节点为空,那么此时遍历到的节点就是整个链表的最后一个节点//指定位置插入Status InsertByPosition(ListNode *HeadNode, Elemtype Data, int pos){
if(!HeadNode) return -1; //如果头指针指向空意味着链表中没有元素 if(pos < 1) return -1;
ListNode *NewNode = new ListNode(Data); ListNode *p = HeadNode; int i = 1; while(p && i < pos - 1){ p = p->next; i++; } if(p == nullptr) return -1; //在链表的范围内没有这个位置,返回-1错误 NewNode->next = p->next; p->next = NewNode;}//进行指定位置插入是,需要找到插入位置的前一位,所以循环的条件是pos - 1- 链表的删除,这里只介绍指定位置删除,其他任何删除条件都和指定位置删除类似,只是寻找指定位置的条件不同。
//指定位置删除Status Delete(ListNode *HeadNode, int pos){    if(!HeadNode) return -1; //如果链表为空,则直接返回
ListNode *p = HeadNode; //指向被删除位置的前一个节点 ListNode *q = HeadNode->next; //指向被删除的位置 int i = 1; while(q && i < pos -1){ p = p->next; q = q->next; i++; } if(!q) return -1; //如果寻找到的被删除位置为空则直接返回 p->next = q->next; //链接被删除位置的前后}//删除节点关键是使用双指针遍历,用两个指针保存节点的关系才能保证被删除节点的前后关系- **链表的遍历(查找)**类似于指定位置的操作,指定位置的条件变为查找的条件即可。
2、列表#
列表是一个抽象数据结构,具有无限大的容量,可以基于数组(一般不)和链表实现。
列表其实就是动态数组,在不同的编程语言中都有基于动态数组的列表,Python中list,Java中ArrayList,C++中的Vector和c#中的List。
关于动态数组的一些操作,可以观看《C++中Vector的应用》那篇博客。
3、哈希表(Hash)#
哈希表是一种顺序表,可以用来迅速判断一个元素是否在表中。
哈希表建立索引key和值value之间的关系构成一张表,可以通过任给一个key快速地找到value。在哈希表中进行增删改查的时间复杂度都是常数级别,用空间换时间。
哈希函数通过将key映射到存储桶中,以实现在桶中的快速搜索。往往使用大量的空间,使得一个key只对应一条数据。
- C++实现哈希表 c++中提供了三种set和三种map
unordered_map<int, string> map;
/* 添加操作 */// 在哈希表中添加键值对 (key, value)map[12836] = "小哈";map[15937] = "小啰";map[16750] = "小算";map[13276] = "小法";map[10583] = "小鸭";
/* 查询操作 */// 向哈希表中输入键 key ,得到值 valuestring name = map[15937];
/* 删除操作 */// 在哈希表中删除键值对 (key, value)map.erase(10583);
/* 遍历哈希表 */// 遍历键值对 key->valuefor (auto kv: map) { cout << kv.first << " -> " << kv.second << endl;}// 使用迭代器遍历 key->valuefor (auto iter = map.begin(); iter != map.end(); iter++) { cout << iter->first << "->" << iter->second << endl;}- c语言实现哈希表 一般使用数组结构存储。
如果不能够一一对应,就会出现哈希冲突,解决哈希冲突的方法
4、二叉树(BinaryTree)#
二叉树是一种非线性的数据结构,每个节点可以包含自己的值,左节点和右节点。二叉树可以充分发挥分支的思想,分别从左右子树进行操作,能够减少一些操作的时间复杂度。当二叉树为完美二叉树时,能充分发挥二叉树的时间优势,在极端情况下二叉树可能成为链表,即每一个节点都只具有一个子节点。
完美二叉树又被称为满二叉树,树的每一层都是满的。
完全二叉树只有最底层的节点没有被填满,且最底层的节点从左向右填满。
完满二叉树除了叶节点之外,所有的节点都具有两个子节点。
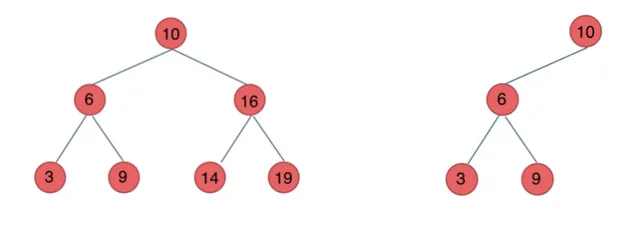
**二叉搜索树(BST)**是一个有序树,若左子树不为空那么左子树上的所有值都小于根节点,右子树则反之,所有的值大于根节点。**平衡搜索树(AVL)**是二叉搜索树的一种,左右子树的高度之差不超过1。
如下图右边的树就不是平衡搜索树
- 数据结构定义
struct TreeNode{ Elemtype data; //数据 TreeNode *leftchild; //左孩子 TreeNode *rightchild; //右孩子 TreeNode(Elemtype x): data(x), leftchild(NULL),rightchild(NULL){};};- 创建根节点
//创建二叉树的根节点TreeNode *createBinaryTree(int x){ TreeNode *RootNode = new TreeNode(x); return RootNode;}- 层序遍历 也就是广度优先遍历(BFS),对树的每一层进行遍历,一层全部遍历完成后再进行下一层的遍历。
进行广度优先遍历经常使用队列(queue)数据结构
vector<Elemtype> levelOrderTraversal(TreeNode* root){ vector<Elemtype> val; queue<TreeNode*> queue;//借助队列数据结构进行遍历 queue.push(root); while(!queue.empty()){ TreeNode* node = queue.front();//从队列中取出第一个 val.push_back(node->data); //取出这个节点的数据 queue.pop();//出队列 if(node->leftchild != NULL) queue.push(node->leftchild); if(node->rightchild != NULL) queue.push(node->rightchild); //先后入队左右孩子 }//直到队列为空 return val;//返回所有的取值}- 深度优先遍历(DFS) 在树中有三种遍历次序,两种实现方法。可以进行先序遍历、中序遍历和后序遍历,只是遍历的顺序有所不同。也有两种实现方式分别是递归和迭代,递归就是自己编写递归函数自己调用自己,迭代是借用栈的数据结构。
//递归法实现深度优先遍历void preOrderTraversal(TreeNode* root){ if(root == nullptr) return; //空节点就直接返回,递归的归 //root->data对root节点的数据进行访问 //例如打印或者放入全局变量中或者添加一个参数传入数组 preOrderTraversal(root->leftchild); preOrderTraversal(root->rightchild); //先序遍历中先访问根节点数据然后访问左右子树}void inOrderTraversal(TreeNode* root){ if(root == nullptr) return; //空节点就直接返回 inOrderTraversal(root->leftchild); //root->data对root节点的数据进行访问 //例如打印或者放入全局变量中或者添加一个参数传入数组 inOrderTraversal(root->rightchild); //中序遍历中先访问左节点然后是根节点最后是右节点}void postOrderTraversal(TreeNode* root){ if(root == nullptr) return; //空节点就直接返回 postOrderTraversal(root->leftchild); postOrderTraversal(root->rightchild); //root->data对root节点的数据进行访问 //例如打印或者放入全局变量中或者添加一个参数传入数组 //后序遍历在访问左右子树后再访问根节点}//迭代法实现深度优先遍历vector<Elemtype> preOrderTraversal(TreeNode* root){ vector<Elemtype> val; stack<TreeNode*> stack; //借助栈结构进行遍历 stack.push(root); //将根节点压栈 while(!stack.empty()){ TreeNode* node = stack.pop(); //直接弹出进行根节点的遍历 val.push_back(node->val); if(!root->rightchild) stack.push(root->rightchild); if(!root->leftchild) stack.push(root->leftchild); //先压入右孩子才能保证左孩子先出栈
} return val;}vector<Elemtype> inOrderTraversal(TreeNode* root){ vector<Elemtype> val; stack<TreeNode*> stack; TreeNode* cur = root; while(!stack.empty() || cur != null){ if(cur != null) { stack.push(cur); //将遍历到的节点压栈 cur = cur->left; //继续向左子树遍历 } //如果遍历到左子树为空,则返回上一个节点 else{ cur = stack.pop(); val.push_back(cur->val); //将上一个节点数据取出 cur = cur->right; //尝试向右遍历 } } return val;}vector<Elemtype> postorderTraversal(TreeNode* root){ vector<Elemtype> val; stack<TreeNode*> stack; TreeNode* cur = root; TreeNode* pre = null; while(!stack.empty() || cur){ while(cur){ stack.push(cur); cur = cur->left; } cur = stack }}先序遍历中进行数据操作的节点和遍历的节点是同一个,所以只要栈空了,就意味着没有要处理的数据了
中序遍历中进行数据操作的节点和遍历的节点不是同一个,从上向下遍历入栈后才能进行出栈进行数据操作,所以栈空了不意味着遍历停止了,那么循环就有两个条件,要保证接下来没有要遍历的节点了而且栈里面也没有要入栈的节点了
三、动态规划#
动态规划(Dynamic Programming)是一种编程的思路,将一个大型的问题分解为若干个更小的子问题,并且在这些子问题中寻找最优的子结构,子问题最终就汇成了大问题的答案。
找到重叠子问题,使用记忆化搜索将计算过的子问题的结果存储起来,需要计算时就看这个结果是否被计算过直接拿来使用。单纯的记忆化搜索或者回溯是一个自顶向下的问题,动态规划则是一个自下而上的问题,从子问题开始使用备忘录进行记录,一直到最大问题。
int mem[10]; //创建备忘录数组memset(mem, -1, sizeof(mem)); //将数组初始化为不可能为结果的数字,表示这个值没有被计算过if(mem[i] > 0) dp[i] = mem[i]; //如果调用dp[i]时已经存在过备忘录中,也就是值不为负一,直接调用mem[i]else dp[i] = fdp(i); //如果不存在就进行递归的计算,计算后还要将结果存入到备忘录中**动态规划问题的特征:**先观察是否符合回溯的决策树模型,也就是在每一个决策点产生一种状态。
其次包含最大、最优之类的问题;每一种状态都可以用有限的矩阵和列表表示出来。
- 二维动态规划化成一维:在一个二维的动态规划中,如果推算一个状态时,他的上一列或者上一行状态已经被完全推算出来,并且这个状态只依赖于上一行或者上一列,(即推算不依赖于更前面的状态)那么可以将上一行或者上一列状态所用的一维数组的空间来存放这个状态。
1、0-1背包问题#
现在有n件物品,背包的容量为m,每一件物品都有自己的价值v[i]和重量w[i],尽可能的将物品放进背包内从而使得所携带的物品总价值最高。
- 代码思路:利用一个二维的dp数组,表示在背包容量为x时挑选前y件物品时最大的价值,对于每一件物品都有两个选择,一个是拿另一个是不拿。